Télécharger Voice Design AI – Synthèse texte‑à‑voix avancée, clonage de voix et synthèse sensible aux émotions
Vue d’ensemble
Voice Design AI est une application web de pointe qui exploite des modèles d’apprentissage profond pour transformer du texte ordinaire en parole réaliste. Destinée aux développeurs, podcasteurs, concepteurs de jeux et à tout créateur ayant besoin d’audio de haute qualité, la plateforme combine le traitement du langage naturel (NLP), la reconnaissance des émotions et la prise en charge multilingue dans une interface unique et facile d’utilisation. Que vous produisiez un livre audio, créiez un assistant virtuel ou ajoutiez des dialogues à un jeu vidéo, Voice Design AI offre un environnement sécurisé, basé sur un abonnement, où vous pouvez générer, éditer et exporter du contenu vocal en quelques clics seulement. Le service propose également une API puissante pour l’intégration en temps réel, permettant aux développeurs d’intégrer une sortie vocale réaliste directement dans des applications, des chatbots ou des installations interactives. Avec le clonage de voix à partir de courts échantillons, des contrôles personnalisables de hauteur, de vitesse et de timbre, ainsi que le traitement en temps réel pour les interactions en direct, l’outil se démarque comme une solution polyvalente et pérenne pour quiconque souhaite ajouter une parole authentique et humaine à ses projets.
Fonctionnalités principales qui distinguent Voice Design AI
- Compréhension du langage naturel : Le NLP avancé interprète le contexte, la ponctuation et la syntaxe pour fournir une intonation naturelle et des pauses.
- Synthèse sensible aux émotions : Choisissez parmi les tons de joie, tristesse, excitation ou neutre ; le moteur module la prosodie pour correspondre au sentiment souhaité.
- Bibliothèque multilingue : Prend en charge plus de 30 langues et dialectes, chacun avec une phonétique propre à la région pour une sortie authentique.
- Clonage de voix : Téléversez un court échantillon de 30 secondes et créez un modèle vocal personnalisé qui imite le timbre et le style du locuteur.
- Traitement en temps réel : Diffusez du texte et recevez un audio instantané, idéal pour les chatbots interactifs et la narration en direct.
- Contrôles de paramètres étendus : Ajustez la hauteur, la vitesse, le volume, la respiration et l’articulation pour affiner le son final.
- Intégration API & SDK : API RESTful avec documentation complète ; les SDK pour JavaScript, Python et C# simplifient l’intégration.
- Stockage cloud sécurisé : Tous les fichiers audio générés sont chiffrés au repos et en transit, conformes aux normes GDPR et ISO‑27001.
- Traitement par lots & gestion de la file d’attente : Téléversez des listes CSV ou JSON pour une conversion en masse ; le système met les tâches en file d’attente et notifie via webhook.
- Mises à jour régulières du modèle : Des versions mensuelles améliorent le réalisme vocal, ajoutent de nouvelles langues et affinent le mapping des émotions.
Installation, utilisation & compatibilité
Voice Design AI est une solution SaaS pure, il n’est donc pas nécessaire d’une installation traditionnelle. Il suffit de visiter le site officiel, de créer un compte et de sélectionner le niveau d’abonnement correspondant à vos besoins en volume. Après avoir confirmé votre e‑mail, vous serez dirigé vers un tableau de bord épuré où vous pouvez commencer à taper ou à téléverser des fichiers texte. Pour les développeurs, la clé API est générée dans l’onglet « Developer » ; copiez‑la dans l’en‑tête de votre application et commencez à envoyer des requêtes POST à https://api.voicedesign.ai/v1/synthesize. La plateforme fournit des extraits de code pour les langages populaires, rendant la courbe d’apprentissage peu raide.
Comme le service fonctionne entièrement dans le cloud, il est compatible avec tout système d’exploitation disposant d’un navigateur web moderne — Windows 10/11, macOS Monterey et versions ultérieures, distributions Linux, ainsi que les plateformes mobiles comme Android 12 et iOS 16. L’interface web est réactive, vous permettant de générer et d’apercevoir l’audio sur tablettes ou smartphones sans perdre de fonctionnalités. Si vous préférez un flux de travail local, l’API peut être appelée depuis des applications de bureau construites avec Electron, .NET ou Java, assurant une intégration fluide sur les environnements Windows, macOS et Linux.
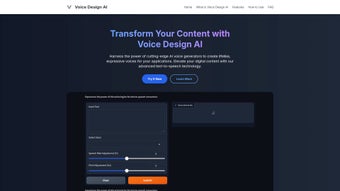
Le flux d’utilisation typique est simple : 1) Choisissez une voix ou téléversez un échantillon de clonage, 2) Saisissez ou collez le script, 3) Sélectionnez la langue et le ton émotionnel, 4) Ajustez les paramètres optionnels, et 5) Cliquez sur « Generate ». La forme d’onde résultante apparaît dans le volet d’aperçu, où vous pouvez écouter, télécharger au format MP3/WAV ou envoyer directement vers le stockage cloud (Amazon S3, Google Cloud ou Azure). Pour les tâches par lots, accédez à l’onglet « Batch », téléversez un CSV avec des colonnes pour le texte, la langue et l’émotion, et laissez le système gérer le reste. Les notifications sont envoyées par e‑mail ou webhook lorsque le traitement est terminé, maintenant votre flux de travail sans interruption.
Avantages, inconvénients, FAQ & conclusion
Avantages
- Synthèse haute fidélité, sensible aux émotions, qui rivalise avec les narrateurs humains.
- Le clonage de voix à partir d’échantillons minimes économise du temps et des coûts de licence.
- Large prise en charge des langues et contrôles de paramètres flexibles.
- API robuste et SDK pour une intégration fluide dans les pipelines existants.
- Stockage cloud sécurisé, conforme au GDPR, avec transfert de données chiffré.
Inconvénients
- Le prix de l’abonnement peut être élevé pour les hobbyistes occasionnels.
- La latence du traitement en temps réel peut varier selon la charge du serveur.
- Le clonage de voix nécessite un échantillon clair et de haute qualité ; les enregistrements bruyants réduisent la précision.
- Pas d’option de déploiement sur site pour les environnements ultra‑sensibles.
- Les fonctionnalités avancées (file d’attente par lots, émotions personnalisées) sont limitées aux plans de niveau supérieur.
FAQ
Puis-je utiliser Voice Design AI pour des projets commerciaux ?
Oui. Tous les niveaux d’abonnement incluent une licence d’utilisation commerciale, vous permettant d’intégrer l’audio généré dans des applications, vidéos, jeux et supports marketing sans redevances supplémentaires.
Quelle quantité de texte puis‑je synthétiser dans une seule requête ?
L’API accepte jusqu’à 5 000 caractères par requête pour les appels en temps réel. Pour des scripts plus longs, utilisez le point de terminaison batch, qui traite des fichiers jusqu’à 50 Mo.
Une version d’essai gratuite est‑elle disponible ?
Un essai gratuit de 7 jours est proposé avec un crédit de 5 000 caractères. Aucune information de carte de crédit n’est requise, et vous pouvez annuler à tout moment avant la fin de l’essai.
Quels formats de fichier puis‑je exporter ?
L’audio peut être téléchargé au format MP3 (128‑320 kbps) ou WAV sans perte (44,1 kHz, 16 bits). L’API prend également en charge le streaming direct vers le stockage cloud dans ces formats.
Quel niveau de sécurité mes données possède‑t‑elles ?
Toutes les données sont chiffrées avec TLS 1.3 pendant la transmission et AES‑256 au repos. Le service est conforme au GDPR, CCPA et ISO‑27001, garantissant que votre texte et l’audio généré restent privés.
Conclusion & appel à l’action
Voice Design AI propose un moteur texte‑à‑voix de qualité professionnelle qui combine nuance émotionnelle, capacités multilingues et API flexible—le tout au sein d’une plateforme sécurisée, orientée cloud. Bien que le coût de l’abonnement puisse être un facteur pour les utilisateurs occasionnels, la qualité du rendu, la facilité d’intégration et l’ensemble de fonctionnalités robustes en font un choix convaincant pour les entreprises et les créateurs qui exigent une synthèse vocale réaliste à grande échelle. Prêt à donner à vos projets une voix naturelle et expressive ? Inscrivez‑vous à l’essai gratuit dès aujourd’hui et découvrez le futur de la création audio pilotée par l’IA.